علیبابا مدل Qwen4-Max را با معماری MoE دو و نیم تریلیون پارامتری و پنجره زمینه یک میلیون توکنی عرضه کرد
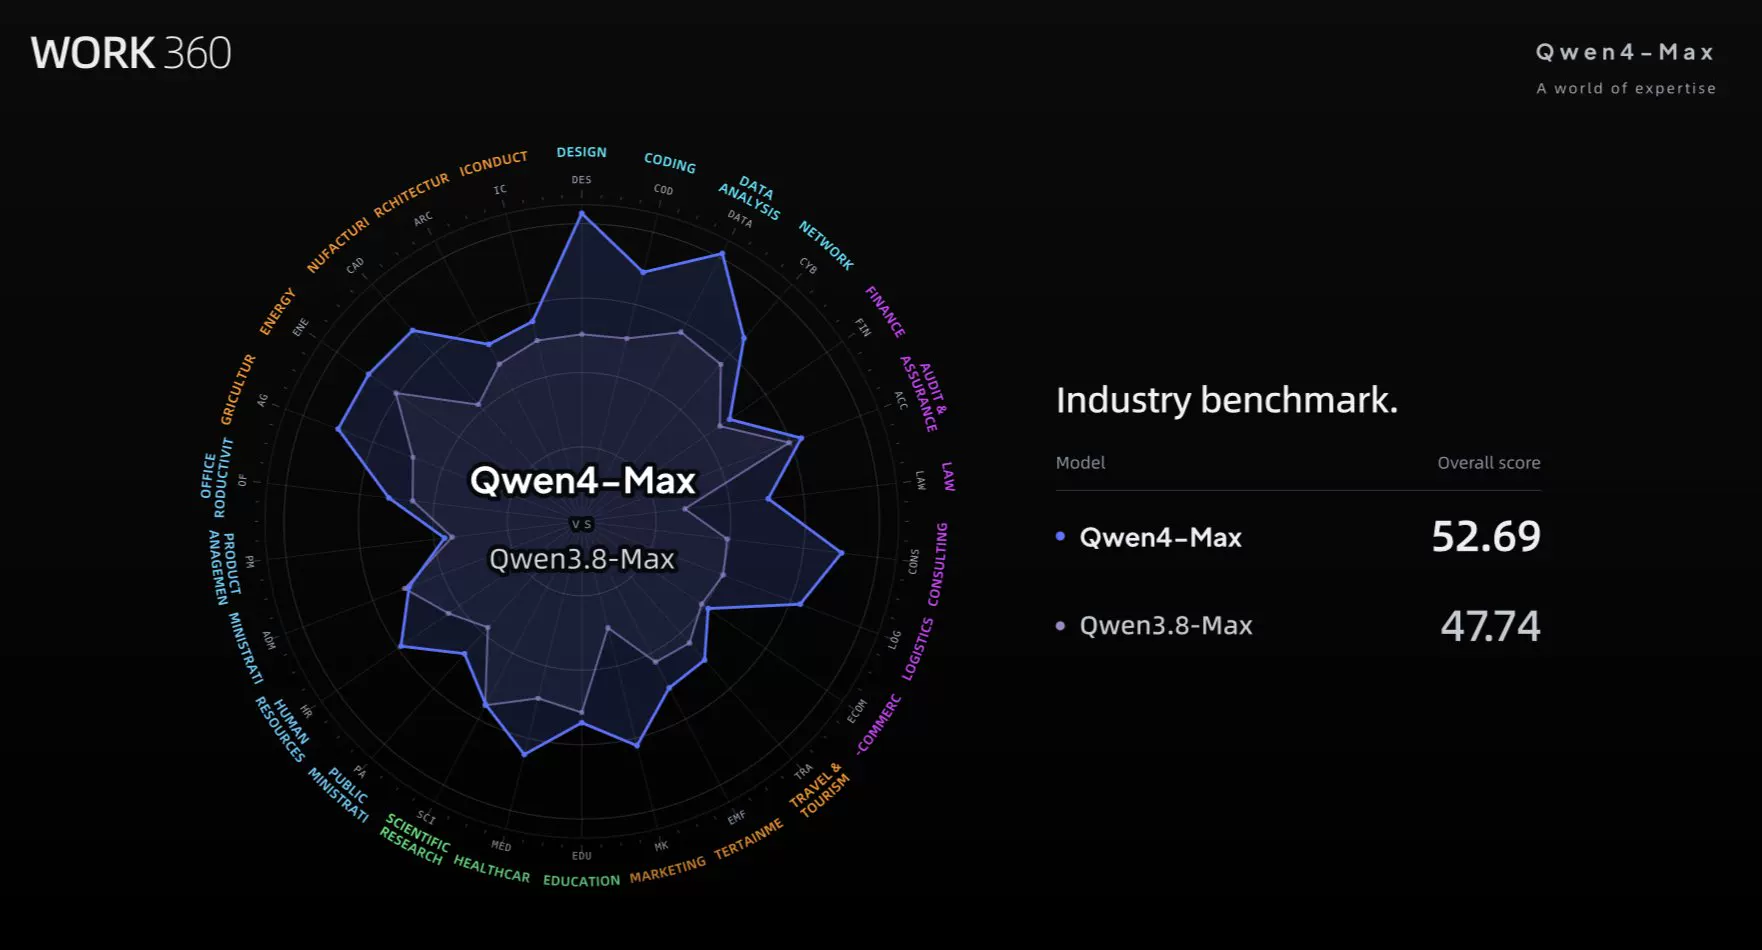
علیبابا در ۱۶ نوامبر مدل Qwen4-Max را معرفی کرد؛ قدرتمندترین مدل زبانی این شرکت تاکنون که بر پایه معماری mixture-of-experts با ۲.۴ تریلیون پارامتر ساخته شده و میتواند تا یک میلیون توکن را در یک پنجره زمینه پردازش کند. این مدل ورودیهای متنی، تصویری و ویدئویی را پشتیبانی میکند و از طریق QwenCloud API، Qwen Studio، QwenWork و Qoder در دسترس است.
این عرضه مستقیمترین چالش علیبابا در برابر ارائهدهندگان هوش مصنوعی پیشرو به شمار میرود. قیمت API برای توکنهای ورودی ۱.۵۰ دلار و برای توکنهای خروجی ۴.۵۰ دلار به ازای هر میلیون توکن تعیین شده است. علیبابا اعلام میکند این مدل نسبت به نسل قبلی (Qwen3.8-Max) حدود ۲۵ درصد پارامترهای فعال کمتری دارد که هزینههای inference را کاهش میدهد.
بر اساس benchmark داخلی Work360 علیبابا، میانگین هزینه هر وظیفه از ۴.۴۳ دلار به ۱.۶۷ دلار کاهش یافته است. با این حال Artificial Analysis در آزمایشهای مستقل هزینه ۳.۲۷ دلار به ازای هر وظیفه Intelligence Index گزارش کرده که در مقایسه با ۳.۶۸ دلار Kimi K3.1 Pro قرار دارد.
از نظر قابلیت، تصویر مختلط است. Artificial Analysis این مدل را با امتیاز ۴۳ در Intelligence Index رتبهبندی میکند که به مراتب پایینتر از Claude Fable 5.2 (65)، Gemini 4 Carbon (60) و Claude Opus 5.5 (59) است. سرعت پردازش نیز نگرانکننده است: حدود ۳۲ دقیقه برای هر وظیفه و ۱۵۹ ثانیه تا اولین خروجی.
علیبابا قول داده مدلهای Qwen4 با وزنهای باز و مقیاس کوچکتر را برای توسعهدهندگان منتشر کند، اما تاریخ انتشار یا شرایط مجوز را اعلام نکرده است. این API از tool calling، structured outputs، جستجوی وب، batch processing و فرمتهای API شرکتهای OpenAI و Anthropic پشتیبانی میکند.
بر اساس گزارش VentureBeat، این عرضه در اوج رقابت قیمتی در بازار هوش مصنوعی سازمانی صورت میگیرد. Qwen4-Max به عنوان گزینهای مقرون به صرفه برای بارهای کاری که به دقت در سطح frontier نیاز ندارند، جایگاه مییابد، اگرچه شکاف با مدلهای پیشرو غربی در وظایف پیچیده استدلالی همچنان قابل توجه است.
در ابتدا توسط Alibaba Cloud گزارش شده است. برای جزئیات بیشتر مقالهٔ اصلی را بخوانید.
مشاهدهٔ منبع اصلی