OpenTelemetry se ha convertido en el estándar de observabilidad — ahora viene la parte difícil de usarlo realmente
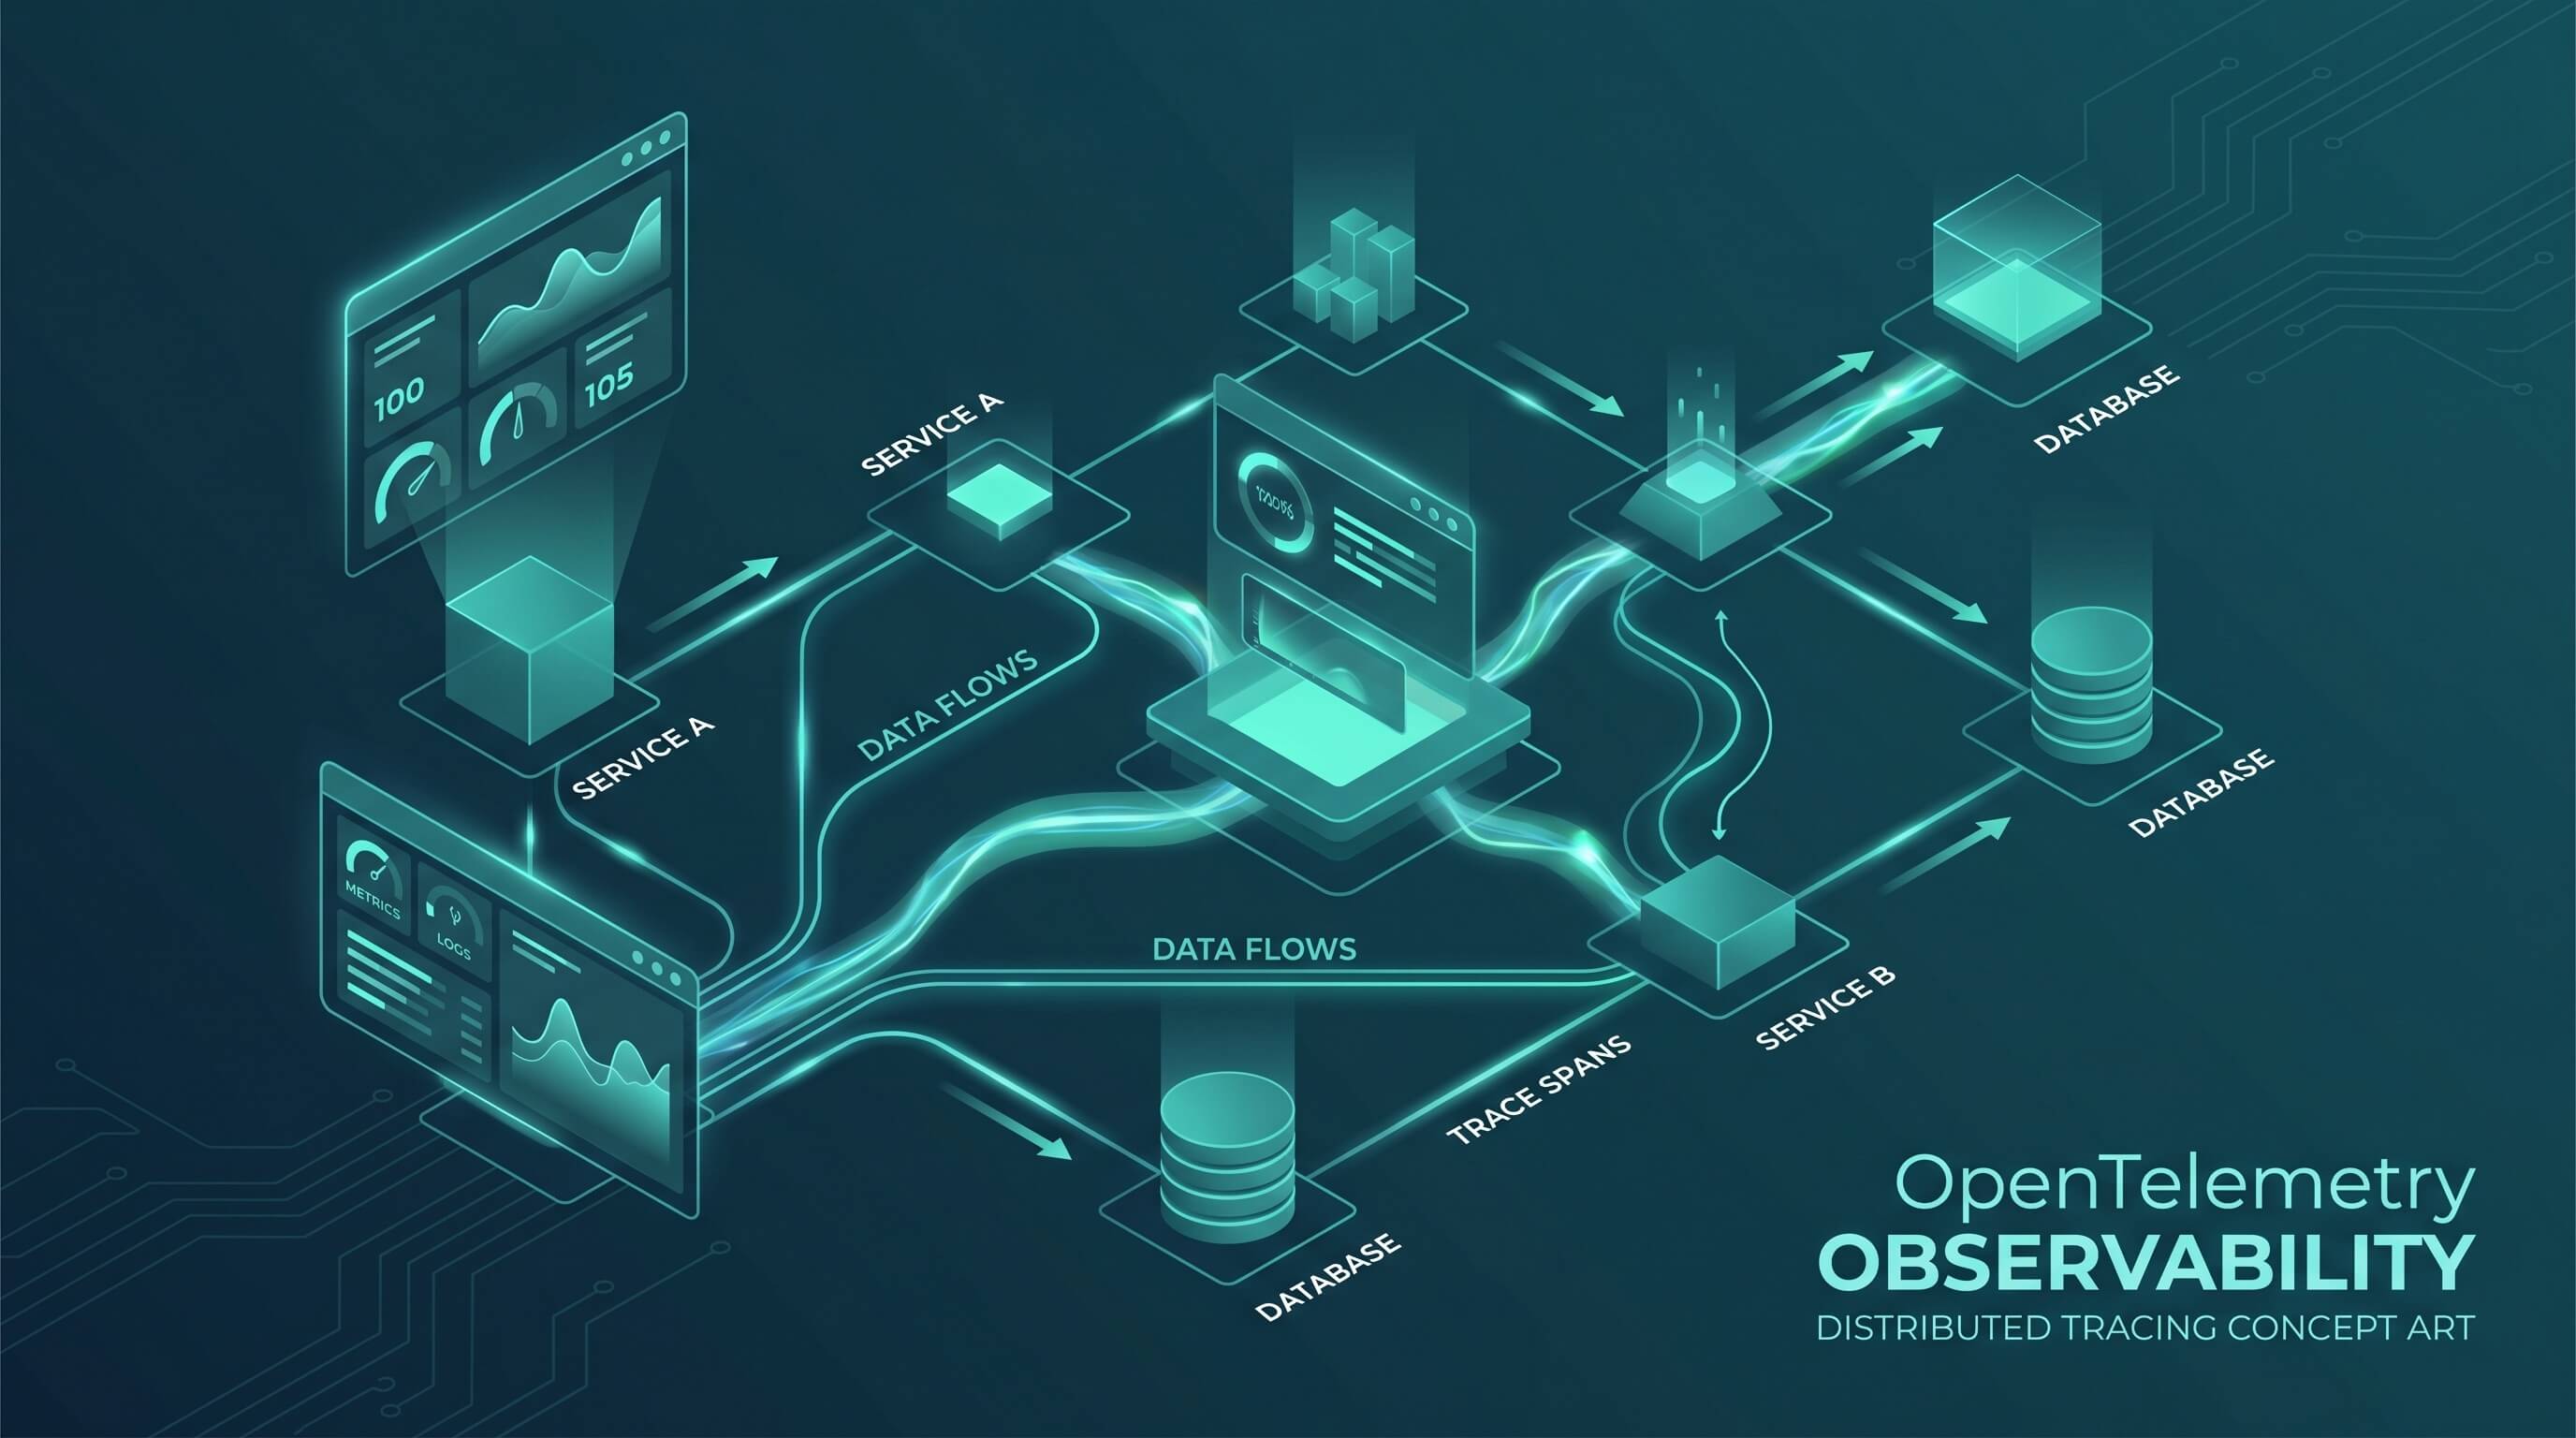
Hace tres años, los equipos de ingeniería que elegían una pila de observabilidad enfrentaban una decisión dolorosa: adoptar los agentes de instrumentación propietarios de un proveedor y aceptar el vendor lock-in, o unir herramientas de código abierto dispares y aceptar la carga de mantenimiento. OpenTelemetry — el proyecto de la CNCF que fusionó OpenCensus y OpenTracing en 2019 — ha resuelto en gran medida esa decisión. Para 2026, se ha convertido en el estándar de facto para la recolección de datos de telemetría en toda la industria.
Datadog, Honeycomb, Grafana, New Relic, Dynatrace y Splunk aceptan datos de OpenTelemetry de forma nativa. Los proveedores de nube, incluidos AWS, Google Cloud y Azure, tienen integración nativa con OpenTelemetry. Los SDKs para Python, Java, Go, JavaScript y .NET han alcanzado versiones estables. El OpenTelemetry Collector — el componente de pipeline que recibe, procesa y exporta la telemetría — está desplegado en producción en empresas que van desde pequeñas startups hasta hiperescaladores.
OpenTelemetry ganó la guerra de la instrumentación. El siguiente problema es usarlo bien.
Lo que OpenTelemetry estandariza realmente
OpenTelemetry define tres señales de telemetría: trazas (el recorrido de una solicitud a través de servicios distribuidos), métricas (mediciones numéricas a lo largo del tiempo) y logs (registros de eventos estructurados). El proyecto proporciona SDKs para generar estas señales, un formato de transmisión (OTLP — Protocolo OpenTelemetry) para enviarlas y el Collector para enrutarlas a los backends.
Lo que no estandariza es qué hacer con los datos una vez que los tienes. Los lenguajes de consulta, los modelos de alertas, las herramientas de dashboards y los flujos de trabajo de análisis son específicos de cada backend. Cambiar de Datadog a Grafana aún requiere reescribir dashboards y alertas — la capa de recolección de datos ahora es portable, pero la capa de análisis no lo es. Este es el problema de la "portabilidad de la observabilidad" que la industria aún está resolviendo.
Dónde se atascan los equipos
El modo de fallo más común es tratar a OpenTelemetry como una casilla de verificación en lugar de una práctica. Los equipos instrumentan sus servicios, ven trazas apareciendo en su backend de observabilidad y declaran el éxito. Seis meses después, cuando ocurre un incidente en producción, descubren que las trazas están incompletas (algunos servicios no estaban instrumentados), los spans carecen de atributos útiles (sin IDs de usuario, sin feature flags, sin contexto de negocio) y la cardinalidad de sus métricas ha superado los límites de su backend.
La calidad de la instrumentación es la primera brecha. La auto-instrumentación — donde el SDK genera automáticamente spans para llamadas HTTP, consultas a bases de datos y operaciones de colas de mensajes — captura el esqueleto estructural de una solicitud pero nada sobre la lógica de negocio. Si una llamada API fue para un cliente premium o de nivel gratuito, qué feature flag estaba activo, cuál era el total del carrito: estos son atributos que requieren instrumentación manual para capturarse. Los equipos que obtienen más valor de OpenTelemetry son los que tratan los atributos de los spans como un producto de un diseño deliberado en lugar de una generación automática.
La cardinalidad es la segunda brecha. Cada combinación única de valores de atributos crea una nueva serie temporal en un backend de métricas. Una métrica etiquetada con ID de usuario, región, feature flag y código de estado HTTP puede crear millones de series distintas — y muchos backends de observabilidad cobran por serie temporal o imponen límites estrictos. Los equipos que instrumentan métricas sin pensar cuidadosamente en la cardinalidad terminan pagando facturas de observabilidad inesperadamente grandes o alcanzando límites de pérdida de datos justo cuando más necesitan los datos.
El Collector como un activo estratégico
El OpenTelemetry Collector es posiblemente el componente más infrautilizado del ecosistema. La mayoría de los equipos lo despliegan como un simple reenviador — recibe OTLP de los servicios, exporta al backend. La pipeline de procesadores del Collector puede hacer mucho más: filtrar datos de alta cardinalidad antes de que lleguen al backend, muestrear trazas basándose en reglas de negocio (muestrear el 100% de las trazas con error, el 1% de las exitosas), enriquecer spans con metadatos de Kubernetes o de descubrimiento de servicios, y enrutar diferentes señales a diferentes backends.
Una pipeline del Collector bien configurada puede reducir los costos de observabilidad entre un 60 y un 80% sin perder señal significativa, al eliminar de forma agresiva datos de bajo valor (trazas de health checks, trabajos en segundo plano rutinarios) mientras preserva todo lo relevante para la depuración y el análisis de negocio. Los equipos que tratan al Collector como infraestructura para configurar cuidadosamente en lugar de desplegar y olvidar, extraen dramáticamente más valor del mismo presupuesto.
Convenciones semánticas: el estándar infravalorado
Las convenciones semánticas de OpenTelemetry — una especificación sobre cómo nombrar y estructurar atributos en spans y métricas — son la contribución más infravalorada del proyecto. Cuando cada equipo nombra los atributos de sus spans de base de datos de manera diferente, no puedes escribir dashboards o alertas genéricas que funcionen entre servicios. Cuando todos siguen las mismas convenciones (db.system, db.statement, http.method, http.status_code), las herramientas pueden razonar sobre la telemetría sin configuración específica por servicio.
La adopción de convenciones semánticas aún es incompleta en la práctica. Las convenciones estables cubren HTTP, bases de datos, sistemas de mensajería y RPC — los patrones de infraestructura más comunes. Muchos patrones específicos de la aplicación no están cubiertos o aún están en estado experimental. Los equipos que construyen sobre OpenTelemetry deberían invertir tiempo en definir sus propias convenciones de atributos para el contexto a nivel de aplicación, siguiendo los patrones de nomenclatura que establece el proyecto, para obtener los mismos beneficios de composición en la capa de aplicación.
Cómo luce lo bueno en 2026
Los equipos que obtienen más valor de OpenTelemetry en 2026 comparten algunas características. Tienen un equipo de plataforma o un campeón de observabilidad que posee la configuración del Collector y los estándares de instrumentación. Han definido un conjunto de atributos de span obligatorios para nuevos servicios y los hacen cumplir en la revisión de código. Han realizado un análisis de cardinalidad explícito en sus métricas y han tomado decisiones deliberadas sobre qué dimensiones mantener. Usan muestreo basado en la cola (tail-based sampling) para capturar trazas completas para errores y solicitudes lentas mientras muestrean agresivamente el tráfico rutinario.
También tratan los datos de observabilidad como un producto, no como el desecho de la infraestructura. La pregunta no es "¿estamos recolectando datos?" sino "¿puede el ingeniero de guardia encontrar la causa raíz de un incidente en producción en menos de 10 minutos?" Ese estándar impulsa decisiones de instrumentación diferentes a "¿está corriendo el Collector?".
OpenTelemetry resolvió el problema de coordinación más difícil en observabilidad: lograr que la industria se pusiera de acuerdo en un formato de datos común. La siguiente capa de problemas — qué instrumentar, cómo configurar la pipeline, qué construir encima — son desafíos de ingeniería y organización que cada equipo tiene que resolver por sí mismo. La buena noticia es que la base ahora es lo suficientemente estable como para construir sobre ella.