Alibaba veröffentlicht Qwen4-Max mit 2,4-Billionen-Parameter-MoE und Millionen-Token-Kontext
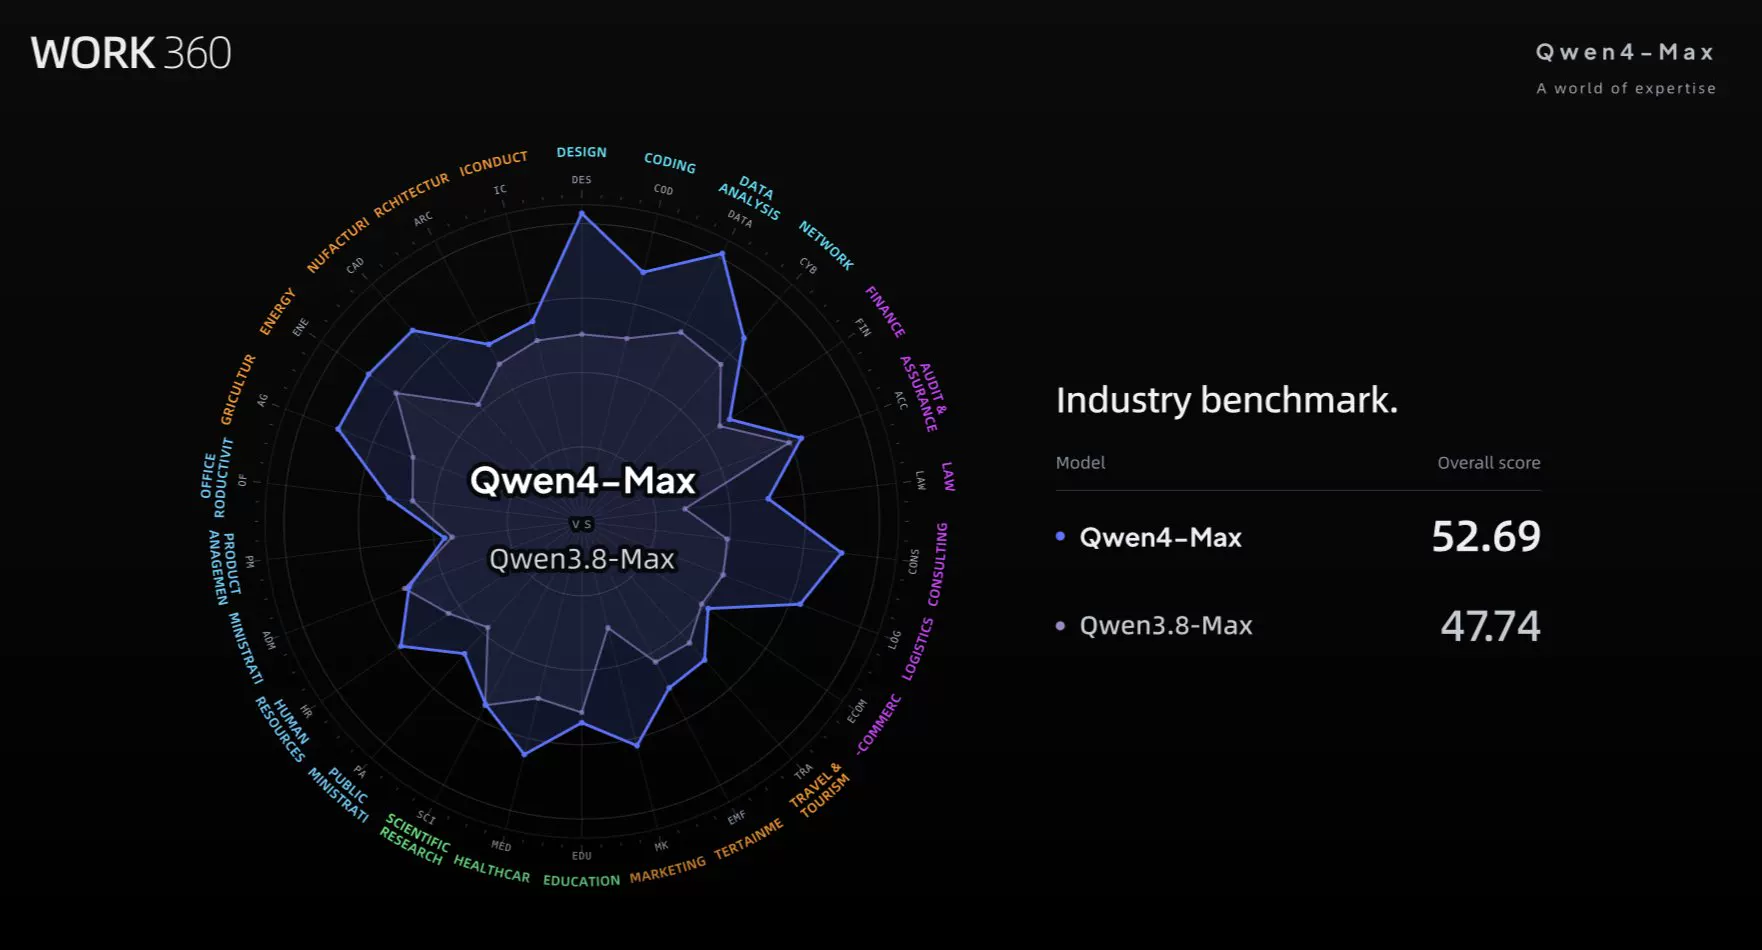
Alibaba veröffentlichte am 16. November Qwen4-Max, sein bislang leistungsfähigstes Sprachmodell, das auf einer Mixture-of-Experts-Architektur mit 2,4 Billionen Parametern basiert und bis zu eine Million Token in einem einzigen Kontextfenster verarbeiten kann. Das Modell akzeptiert Text-, Bild- und Videoeingaben und ist sofort über QwenCloud API, Qwen Studio, QwenWork und Qoder verfügbar.
Der Launch stellt Alibabas direkteste Herausforderung an führende KI-Anbieter dar. Die API-Preise liegen bei 1,50 US-Dollar pro Million Eingabe-Token und 4,50 US-Dollar pro Million Ausgabe-Token, mit gecachten Eingaben bei 0,075 US-Dollar. Alibaba gibt an, dass das Modell rund 25% weniger aktive Parameter als sein Vorgänger Qwen3.8-Max verwendet.
Alibabas internes Work360-Benchmark zeigt eine Kostensenkung von 62% pro Aufgabe. Unabhängige Tests von Artificial Analysis platzieren Qwen4-Max bei 3,27 US-Dollar pro Intelligence-Index-Aufgabe, verglichen mit 3,68 US-Dollar für Kimi K3.1 Pro.
Die Rohleistung ist gemischt. Artificial Analysis bewertet Qwen4-Max mit 43 Punkten auf dem Intelligence Index — weit hinter Claude Fable 5.2 (65), Gemini 4 Carbon (60) und Claude Opus 5.5 (59). Auch die Geschwindigkeit bereitet Sorgen: rund 32 Minuten pro Aufgabe und 159 Sekunden bis zum ersten Ausgabe-Token.
Alibaba hat Open-Weight-Qwen4-Modelle für Entwickler versprochen, ohne Datum oder Lizenzbedingungen zu nennen. Die API unterstützt Tool-Calling, strukturierte Ausgaben, Websuche, Batch-Verarbeitung sowie OpenAI- und Anthropic-API-Formate.
Laut VentureBeat kommt der Launch inmitten eines intensiven Preiswettbewerbs im Enterprise-KI-Markt. Qwen4-Max positioniert Alibaba als kostengünstige Alternative für Workloads, die keine Frontier-Level-Genauigkeit erfordern.
Ursprünglich berichtet von Alibaba Cloud. Lesen Sie den Originalartikel für weitere Details.
Originalquelle ansehen